Du cluster centralisé au fabric distribué
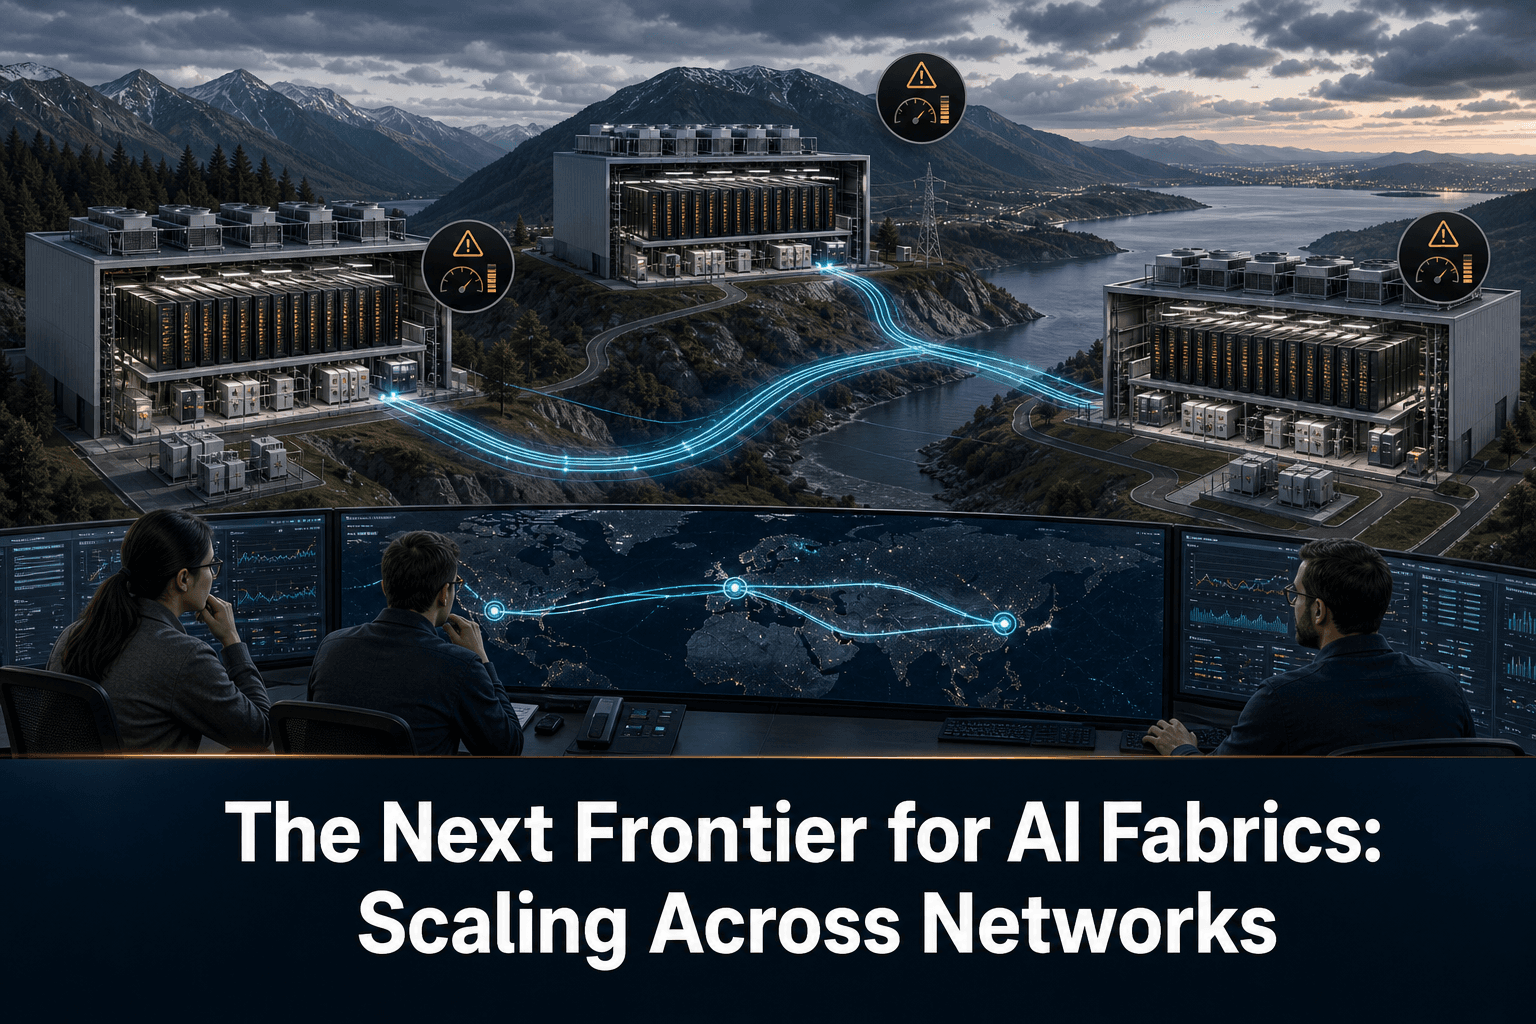
Les charges d’entraînement et les modèles d’IA de pointe continuent de progresser vers des milliers de milliards de paramètres et des millions d’accélérateurs. À cette échelle, ajouter toujours plus d’équipements sur un site unique se heurte à une réalité très concrète : l’espace disponible et la puissance électrique sont limités.
Le modèle scale-across répond à cette contrainte en répartissant la densité de calcul entre plusieurs zones géographiques. Il prolonge à longue distance les principes de scale-up et de scale-out appliqués aux clusters locaux. L’infrastructure IA évolue ainsi d’une pile verticale centralisée vers un fabric horizontal multisite.
Le scale-across ne consiste pas simplement à agrandir un cluster local. Le réseau entre les sites devient une composante à part entière de l’architecture IA.
Une nouvelle architecture réseau
Dans une conception centralisée, les accélérateurs, les ressources de calcul et une grande partie de l’infrastructure associée peuvent être regroupés dans un même bâtiment. Un fabric distribué crée, au contraire, des dépendances qui traversent plusieurs sites physiques.
Les équipes réseau doivent alors prendre en compte :
La connectivité intersite comme dépendance essentielle : les liaisons longue distance ne sont plus périphériques lorsqu’elles relient différentes parties d’un même environnement IA.
La répartition géographique : les ressources de calcul doivent être placées sur des sites disposant de suffisamment d’espace, de puissance électrique et de capacité réseau.
Les domaines de défaillance multisites : un incident, une liaison ou une modification de configuration peut avoir des conséquences au-delà d’un cluster local.
La cohérence des configurations : les équipements distribués doivent fonctionner comme une infrastructure coordonnée, même lorsqu’ils sont déployés dans plusieurs bâtiments.
La topologie de bout en bout : les opérateurs doivent comprendre comment les domaines locaux de scale-up et de scale-out sont reliés au fabric scale-across.
La question n’est donc plus seulement « Jusqu’où pouvons-nous agrandir ce cluster ? », mais « Comment faire fonctionner plusieurs sites comme un seul fabric de calcul cohérent ? »
Une planification de capacité multidimensionnelle
La planification classique se concentre souvent sur les ports, les liens, les baies et la croissance locale. Une infrastructure IA scale-across ajoute à ce calcul la géographie, les limites propres aux bâtiments et la connectivité longue distance.
Une démarche pragmatique doit examiner :
Le placement des ressources de calcul : déterminer où les accélérateurs supplémentaires peuvent être hébergés, tant sur le plan physique qu’électrique.
La capacité du réseau local : vérifier que chaque site peut prendre en charge la densité de calcul prévue.
La capacité intersite : considérer les liaisons longue distance comme une partie du fabric global, et non comme une simple couche de transport séparée.
Les dépendances et les défaillances : documenter les charges et les composants d’infrastructure qui dépendent de chaque site ou chemin réseau.
La marge opérationnelle : prévoir les opérations de maintenance, les changements de configuration et les extensions futures, plutôt que le seul déploiement initial.
Le calcul, les bâtiments et le réseau ne peuvent donc plus être dimensionnés séparément. Un site disposant d’espace au sol ne constitue pas une solution si son alimentation électrique ou sa connectivité réseau ne permet pas d’assumer le rôle envisagé.
Une visibilité opérationnelle qui dépasse les frontières des sites
Une infrastructure distribuée remet également en question les outils et processus organisés autour de data centers pris isolément. Une vue limitée à un équipement ne permet pas d’évaluer toutes les conséquences d’un changement au sein d’un fabric scale-across.
Les équipes d’exploitation doivent pouvoir déterminer :
Quels actifs réseau participent à l’environnement distribué
Comment les équipements et les sites sont interconnectés
Si les configurations ont divergé d’un site à l’autre
Quels changements ont précédé un incident ou un problème opérationnel
Quels actifs présentent des vulnérabilités connues ou approchent de leur fin de vie
Si les configurations restent conformes aux exigences internes et réglementaires
L’objectif n’est pas simplement de collecter davantage de données. Il faut préserver les relations entre les actifs, les configurations, la topologie, le cycle de vie et l’historique des changements à l’échelle de tout le fabric multisite.
La place de ConnectMyAssets
Le réseau scale-across constitue une évolution architecturale portée par les fournisseurs d’infrastructure. ConnectMyAssets apporte une couche de gestion sur site et indépendante des constructeurs afin de conserver une vision claire et maîtrisée du parc réseau multimarque sous-jacent.
Plusieurs modules répondent directement à ces besoins :
CMDB dynamique et Topologie : inventorier les actifs réseau concernés et visualiser leurs relations entre les différents sites.
Backup & History : versionner les configurations, rechercher les changements et restaurer en un clic une configuration prise en charge.
Automation & ZTP : appliquer des changements reproductibles sur une infrastructure distribuée tout en limitant les incohérences manuelles.
Compliance Engine : contrôler les configurations par rapport à des référentiels tels que NIS2, ISO 27001, PCI, CISA et NIST.
Suivi des CVE par actif et suivi de fin de vie : rattacher les informations de sécurité et de cycle de vie aux équipements qui soutiennent le fabric IA.
Credential Vault et SSH Bastion : centraliser les accès administratifs contrôlés sans envoyer les identifiants d’infrastructure vers un service de gestion cloud.
AI Insights local : analyser sur site les informations d’infrastructure, tout en conservant localement les données de gestion.
ConnectMyAssets n’ordonnance pas les charges IA et ne remplace pas les mécanismes de contrôle propres au fabric. Son rôle est de gérer l’infrastructure réseau sur laquelle celui-ci repose : inventaire, topologie, historique des configurations, conformité, cycle de vie et automatisation contrôlée, quels que soient les constructeurs et les sites.
Se préparer à l’ère du scale-across
Avant d’étendre un environnement IA sur plusieurs zones géographiques, les équipes réseau devraient établir une base opérationnelle fiable :
Inventorier chaque actif impliqué dans la connectivité locale et intersite.
Cartographier les dépendances entre les sites, les chemins réseau et les configurations.
Sauvegarder les configurations et conserver un historique auditable des changements.
Détecter les divergences de configuration avant qu’elles ne deviennent un problème multisite.
Intégrer les vulnérabilités et les dates de fin de vie aux décisions de capacité et d’extension.
Définir des automatisations reproductibles pour les changements qui doivent rester cohérents entre les sites.
Les fabrics scale-across apportent une réponse pragmatique aux limites physiques des infrastructures IA centralisées. Ils renforcent aussi l’importance d’une gestion réseau rigoureuse : lorsque le calcul s’étend sur plusieurs zones géographiques, le réseau devient le socle qui relie l’ensemble du système IA.
Source : Arista Networks