Une ressource publique sur la fiabilité des réseaux
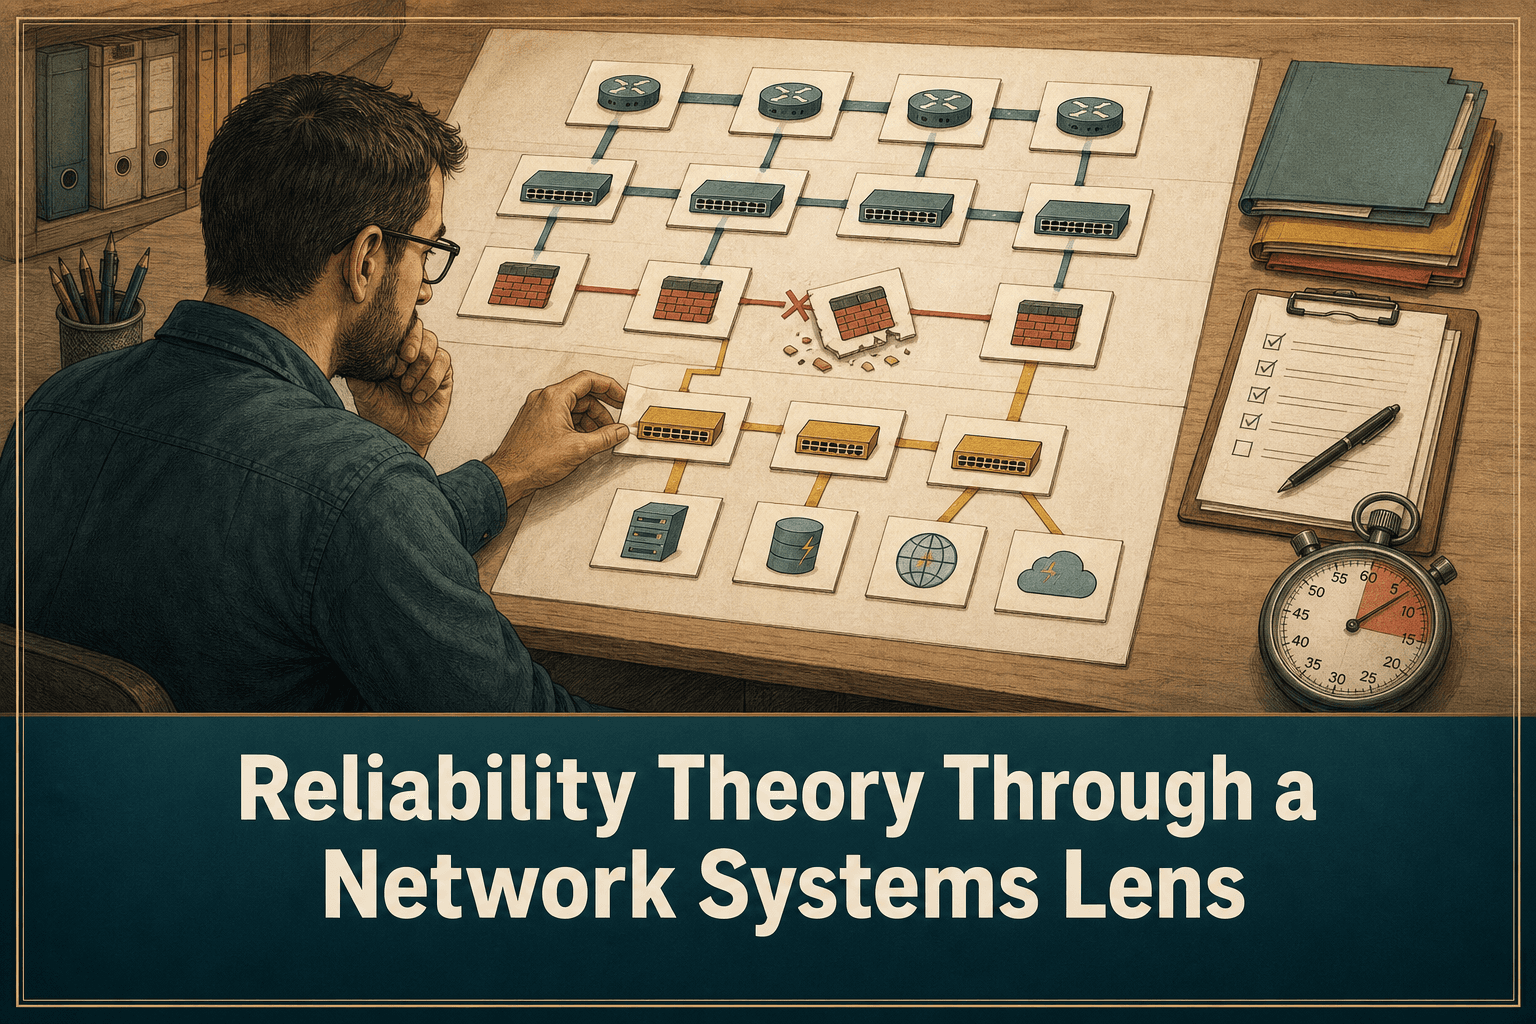
ipSpace.net rend désormais accessible, sans compte ipSpace.net valide, le webinaire de cinq heures de Rachel Traylor intitulé Reliability Theory: Networking through a Systems Analysis Lens. L’annonce renvoie également vers d’autres vidéos gratuites et vers les feuilles de route des webinaires de l’éditeur.
Cette brève annonce ne détaille pas le programme de la formation. Les enseignements ci-dessous ne constituent donc pas un résumé du webinaire : ils prennent son approche par l’analyse des systèmes comme point de départ pour formuler des questions pratiques de conception et d’exploitation.
Partir du service, pas de l’équipement
Un équipement peut rester joignable alors que le service qui en dépend est dégradé. À l’inverse, la panne d’un composant peut rester sans conséquence visible si le système dispose d’un chemin de secours réellement opérationnel.
L’analyse de fiabilité doit donc commencer par la définition de ce qui doit rester disponible :
Quel service utilisateur ou intermachine faut-il protéger ?
De quelles dépendances réseau, sécurité, adressage, authentification, alimentation et connectivité amont dépend-il ?
À partir de quel état parle-t-on de dégradation plutôt que de panne totale ?
Comment les équipes détecteront-elles cet état ?
Que faut-il restaurer en priorité ?
Cette approche déplace l’attention de la santé d’un équipement isolé vers le comportement du service de bout en bout.
Cartographier les dépendances avant d’ajouter de la redondance
La redondance n’est utile que si les composants alternatifs ne partagent pas la même dépendance critique. Deux chemins apparemment distincts peuvent encore dépendre du même pare-feu, de la même alimentation, du même passage physique, du même identifiant, de la même erreur de configuration ou de la même procédure d’exploitation.
Un exercice d’analyse concret consiste à suivre chaque service important au travers de ses dépendances :
Identifier les points d’entrée et de sortie du service.
Répertorier les équipements et fonctions logiques traversés.
Relever les infrastructures et dépendances administratives partagées.
Repérer les endroits où une panne peut être isolée.
Vérifier que le chemin de secours prévu peut réellement transporter le service.
Une topologie et un inventaire à jour permettent de répéter cet exercice sans dépendre uniquement de la mémoire des équipes.
Considérer la configuration comme un élément de fiabilité
La fiabilité du réseau ne relève pas uniquement de l’architecture matérielle. L’état des configurations influence le routage, la segmentation, le contrôle d’accès, l’adressage et les possibilités de restauration.
Plusieurs questions doivent être posées :
Existe-t-il une configuration de référence fiable pour chaque actif critique ?
L’équipe peut-elle déterminer précisément ce qui a changé avant un incident ?
Les sauvegardes sont-elles récentes, complètes et restaurables ?
Le retour arrière repose-t-il sur une procédure établie plutôt que sur une improvisation ?
Les dérives de configuration sont-elles détectables dans un environnement multiconstructeur ?
Une sauvegarde impossible à retrouver, comparer ou restaurer rapidement n’apporte qu’une valeur opérationnelle limitée. L’historique des versions et les procédures de reprise testées transforment les données de configuration en véritable capacité de résilience.
Étudier simultanément la panne et la reprise
Prévenir les pannes ne représente qu’une partie de la fiabilité. Il faut également analyser ce qui se passe une fois l’incident détecté.
Pour chaque scénario important, demandez-vous :
Quel signal ou quelle preuve révèle la panne ?
Qui est responsable de l’intervention ?
Quel chemin d’administration reste disponible pendant l’incident ?
Les identifiants et les informations sur les équipements restent-ils accessibles sur site ?
Quelle configuration ou action automatisée peut être exécutée sans risque excessif ?
Comment la restauration sera-t-elle validée du point de vue du service ?
Cette démarche relie l’architecture aux procédures, aux contrôles d’accès, aux sauvegardes et aux responsabilités opérationnelles. Elle met aussi en évidence les cas où le mécanisme de reprise dépend précisément du système qui vient de tomber en panne.
Faire de chaque changement un test de fiabilité
Un changement planifié permet de vérifier les hypothèses formulées sur le système. Avant l’intervention, l’équipe peut documenter l’impact attendu sur le service, les dépendances, les contrôles de validation et les conditions de retour arrière. Après l’opération, elle peut comparer l’état prévu à l’état réellement observé.
Une méthode rigoureuse comprend les étapes suivantes :
Capturer la configuration avant le changement.
Confirmer les actifs et dépendances concernés.
Définir des critères mesurables de réussite et de retour arrière.
Appliquer le changement contrôlé le plus limité possible.
Valider le service, et pas seulement la joignabilité des équipements.
Conserver la nouvelle configuration et les preuves d’audit.
L’automatisation améliore la régularité des opérations, mais elle doit partir d’entrées vérifiées et prévoir une gestion explicite des échecs. Automatiser une hypothèse erronée revient simplement à la déployer plus vite et plus largement.
Intégrer le cycle de vie, les vulnérabilités et la conformité
L’analyse des systèmes gagne également à inclure des informations qui dépassent la seule topologie. Un actif proche de sa fin de support, concerné par une vulnérabilité connue ou éloigné de la configuration de référence peut modifier le risque associé à une architecture pourtant solide sur le papier.
Ces facteurs doivent être replacés dans leur contexte :
Cycle de vie : le composant peut-il encore recevoir l’assistance du constructeur ou les mises à jour nécessaires ?
Exposition aux vulnérabilités : quels actifs sont concernés et quels services en dépendent ?
Conformité : la configuration actuelle respecte-t-elle les contrôles exigés par l’organisation ?
Capacité de reprise : l’historique des configurations, les identifiants et les procédures seront-ils disponibles au moment voulu ?
Aucune de ces données ne mesure à elle seule la fiabilité. Ensemble, elles aident toutefois à découvrir des dépendances et contraintes opérationnelles absentes des schémas.
Comment ConnectMyAssets peut aider
ConnectMyAssets fournit une base sur site pour transformer les questions issues de l’analyse des systèmes en preuves opérationnelles maintenues dans une infrastructure multiconstructeur.
Le module Dynamic CMDB conserve le contexte des actifs et de leurs dépendances pour les revues de fiabilité.
Le module Topology aide à examiner les chemins et les infrastructures partagées avant un changement ou un exercice de gestion d’incident.
Backup & History apporte le versionnage des configurations, la comparaison des changements et le retour arrière en un clic.
Automation & ZTP prend en charge des workflows de configuration contrôlés et reproductibles.
Credential Vault et SSH Bastion contribuent à préserver un accès administratif gouverné pendant l’exploitation et la reprise.
Le suivi des CVE par actif relie les informations de vulnérabilité aux équipements concernés.
Le module de suivi de fin de vie signale les contraintes de cycle de vie susceptibles de limiter les plans de maintenance et de reprise.
Le Compliance Engine évalue l’infrastructure au regard de référentiels tels que NIS2, ISO 27001, PCI, CISA et NIST.
Ces modules ne prouvent pas à eux seuls qu’un réseau est fiable. Ils fournissent néanmoins l’inventaire, l’historique, les accès, les données de cycle de vie et les preuves de configuration nécessaires pour analyser les hypothèses de fiabilité et agir sur les conclusions.
Une prochaine étape concrète
Le webinaire public peut servir de point de départ à l’examen ciblé d’un service critique. Cartographiez ses dépendances, recherchez les points de panne partagés, confirmez la capacité à restaurer les configurations et vérifiez que les informations opérationnelles suffisent pour assurer la reprise. Un exercice limité mais fondé sur des preuves révèle souvent les hypothèses que les déclarations générales de « redondance » laissent sans vérification.
Source : ipSpace.net