

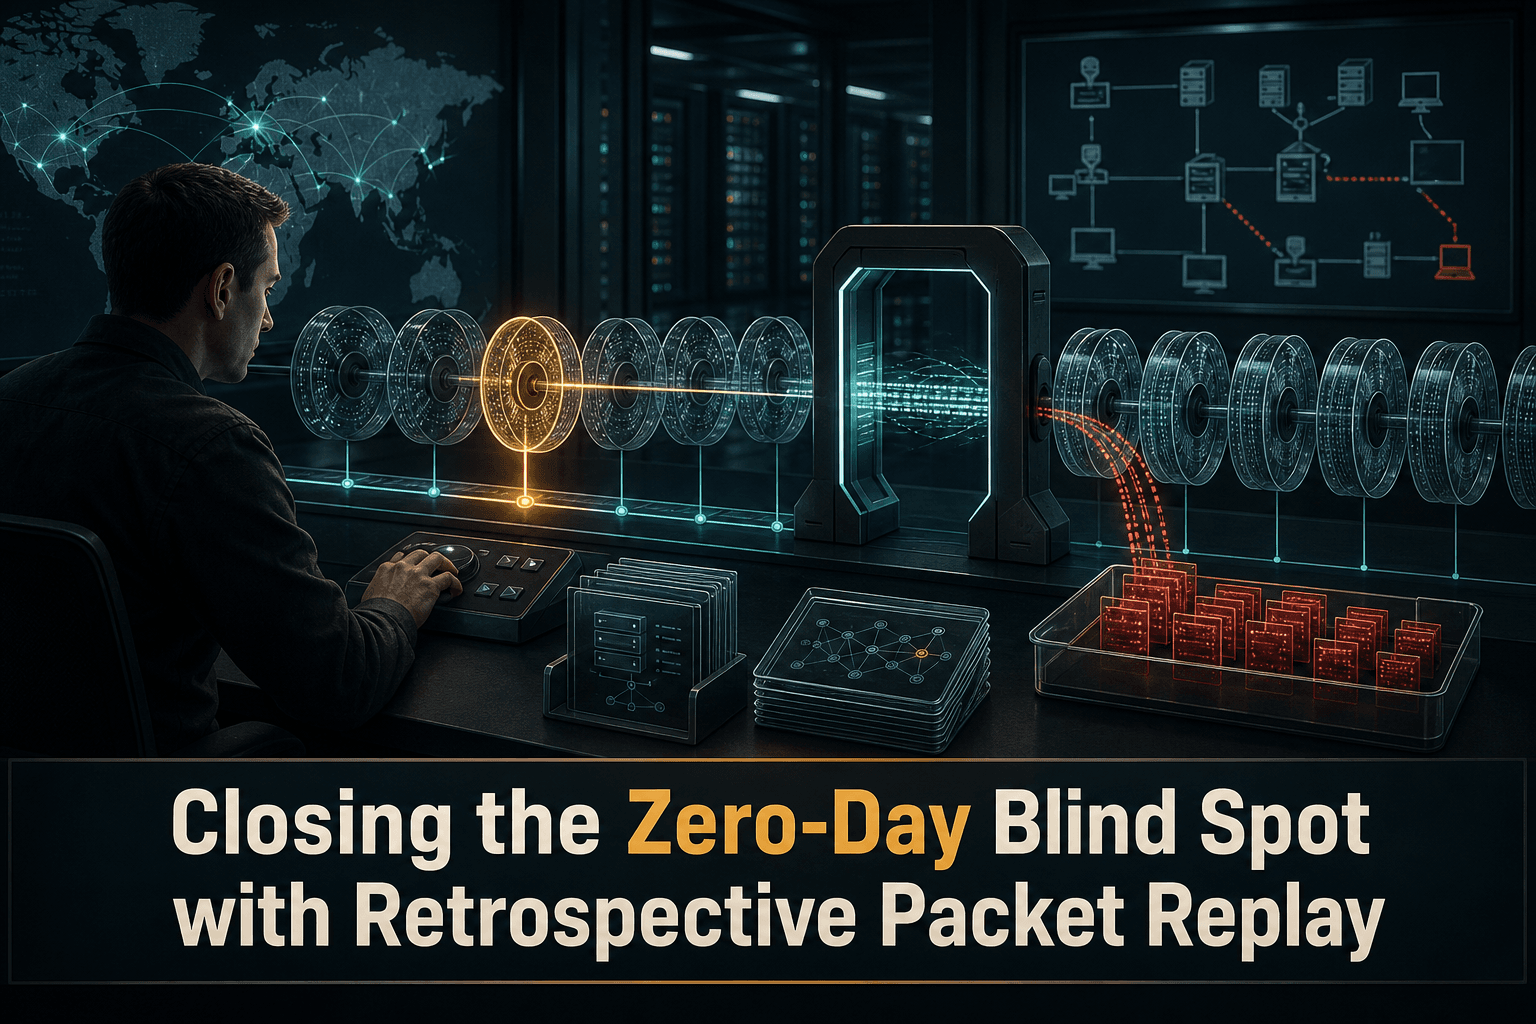
Pourquoi les zero-days imposent une analyse rétrospective
Lorsqu’une nouvelle menace est découverte, une question délicate se pose aux équipes réseau et sécurité : l’activité a-t-elle déjà traversé l’environnement avant qu’une règle de détection n’existe ?
La surveillance en temps réel évalue le trafic avec les connaissances et les contrôles disponibles à l’instant où il circule. Lorsque de nouveaux renseignements sur la menace ou une nouvelle logique de détection arrivent plus tard, les équipes doivent pouvoir appliquer ces connaissances au trafic antérieur.
Dans son exemple du .conf26 Agentic SOC, Cisco décrit l’association de captures complètes de paquets Endace (PCAP), de Cisco Secure Firewall et de règles Talos. Les données précédemment enregistrées sur le réseau ont ainsi pu être rejouées afin d’y appliquer rétrospectivement une logique de détection des zero-days.
Le rejeu des paquets permet d’appliquer de nouvelles connaissances de détection à un trafic qui a déjà circulé sur le réseau.
Du trafic historique à une preuve exploitable
Les PCAP conservés fournissent l’historique du trafic, tandis que les règles mises à jour apportent une nouvelle grille d’analyse. Leur association permet de construire un processus rétrospectif concret :
Conserver le trafic réseau sous forme de captures complètes.
Recevoir une nouvelle logique de détection après la découverte d’une zero-day.
Rejouer le trafic enregistré à travers les contrôles d’inspection concernés.
Identifier les correspondances historiques qui ne pouvaient pas être reconnues lors du passage initial.
Relier les résultats aux actifs et aux configurations concernés.
Appliquer la remédiation et conserver les preuves de l’analyse et des changements effectués.
Cette approche remplace une partie des suppositions par une analyse fondée sur des données réseau observées. Au lieu de se limiter aux alertes actuelles, les équipes peuvent déterminer si un trafic antérieur correspond à des règles élaborées après sa circulation.
Ce que le rejeu permet d’établir — et ses limites
Une correspondance rétrospective constitue un élément de preuve important, mais elle doit être replacée dans son contexte opérationnel. Les équipes doivent relier le résultat du rejeu à l’actif concerné, à son exposition logicielle, à la configuration active au moment des faits et aux mesures correctives appliquées ensuite.
Le rejeu des paquets peut aider à déterminer :
Si le trafic enregistré correspond à une logique de détection nouvellement disponible.
Quelles communications historiques nécessitent une investigation.
À quel moment l’activité réseau concernée s’est produite.
Quels flux doivent être rapprochés des enregistrements d’actifs et de configurations.
Il ne constitue toutefois pas, à lui seul, un dossier complet de remédiation. Il faut encore identifier le responsable de l’actif, valider son exposition, examiner sa configuration, mettre en œuvre les contrôles requis et documenter la clôture.
Construire un processus zero-day défendable
Pour qu’un résultat de rejeu devienne une preuve de remédiation utile, les opérations réseau et sécurité doivent suivre une méthode reproductible.
1. Identifier précisément l’actif concerné
Le flux historique doit être associé à un enregistrement d’actif faisant autorité. Le rôle de l’équipement, son emplacement, son responsable et ses relations avec le reste de l’infrastructure permettent d’évaluer son importance opérationnelle.
2. Reconstituer l’état de la configuration
La configuration actuelle peut différer de celle qui était active lors de l’observation du trafic. L’historique des configurations permet de comprendre quels contrôles étaient alors en place et quels changements ont été réalisés depuis.
3. Valider l’exposition à la vulnérabilité
Une correspondance dans le trafic et la vulnérabilité effective d’un actif sont deux faits liés, mais distincts. Le suivi des vulnérabilités par équipement permet de documenter les raisons pour lesquelles un actif est considéré comme exposé ainsi que la décision de remédiation prise.
4. Appliquer et vérifier la remédiation
La réponse peut prendre la forme d’un changement de configuration, d’un contrôle de pare-feu, d’une correction logicielle ou d’une autre action opérationnelle. Les équipes doivent conserver la modification et sa vérification, plutôt que de simplement indiquer qu’un ticket a été clôturé.
5. Conserver une piste d’audit
Le dossier final doit relier le résultat du rejeu, l’actif touché, l’état de configuration pertinent, l’action corrective et le résultat de sa vérification. Cette continuité facilite aussi bien les revues internes que les rapports de conformité.
Comment ConnectMyAssets vous aide
ConnectMyAssets complète le rejeu rétrospectif des paquets en gérant le contexte des actifs, des configurations et de la remédiation. La plateforme ne remplace pas une solution de capture complète et de rejeu des paquets. Elle aide plutôt les équipes réseau à transformer une détection historique en réponse maîtrisée et auditable dans une infrastructure multiconstructeur.
Dynamic CMDB : associe les résultats du rejeu aux actifs réseau, à leurs responsables et à leurs relations dans l’infrastructure.
Suivi des CVE par actif : consigne l’exposition aux vulnérabilités équipement par équipement et facilite la priorisation du parc concerné.
Backup & History : conserve les versions de configuration afin d’examiner l’état antérieur à la remédiation, de comparer les changements et, si nécessaire, d’utiliser la restauration en un clic.
Firewall Management : aide à mettre en œuvre les changements de pare-feu requis dans un environnement multiconstructeur.
Compliance Engine : structure les preuves de remédiation pour des référentiels tels que NIS2, ISO 27001, PCI, CISA et NIST.
Automation : favorise des processus de remédiation reproductibles plutôt que des interventions manuelles non documentées.
Suivi de fin de vie : met en évidence les équipements touchés qui présentent un risque opérationnel supplémentaire parce qu’ils approchent de leur fin de support ou l’ont déjà atteinte.
Une chaîne de preuves défendable peut ainsi relier :
Le résultat historique du rejeu des paquets.
L’actif identifié et son état de vulnérabilité.
La configuration active pendant la période concernée.
Le changement de remédiation approuvé.
La configuration après changement et la preuve de vérification.
L’enseignement opérationnel
L’intérêt de conserver des captures complètes ne se limite pas à l’analyse de menaces déjà comprises. Leur valeur apparaît pleinement lorsque les connaissances de détection évoluent : les équipes peuvent réexaminer d’anciennes données réseau avec des règles qui n’existaient pas au moment où le trafic a circulé.
Associé à un inventaire fiable, à l’historique des configurations, au suivi des vulnérabilités et à des preuves de conformité structurées, le rejeu rétrospectif transforme la réponse aux zero-days en un processus traçable plutôt qu’en une succession d’hypothèses.
Source : Cisco Blogs


